Bölüm 11:İşlemciyi Hızlandıran Hileler
CPU'ya “Sen”i Katmak kitabının parçası: bilgisayarının programları nasıl çalıştırdığına doğru inen uzun bir teknik tavşan deliği.
Tüm bölümler
- Giriş
- Sayılar: Bit'ten Kayan Noktaya
- Metin, Bellek ve Kod
- Temeller
- Kernel, User Mode ve Syscall
- Mimariler: x86, ARM ve Diğerleri
- Saat, Çekirdek ve Mantıksal İşlemci
- Bellek Hiyerarşisi
- Cache Nasıl Çalışır
- Zamanı Dilimle
- Aynı Anda İki Şey
- İşlemciyi Hızlandıran Hileler
- Tahmin, Spekülasyon ve Spectre
- Bir Program Nasıl Çalıştırılır?
- Shell'den Kernel'e
- Bir ELF Ustasına Dönüşmek
- Bellek Aslında Sanal
- Adres Çevirisi ve TLB
- Bellek Güvenliği ve Sertleştirme
- Fork'lar ve COW'lar Hakkında Konuşalım
- Dosya Sistemi ve I/O
- Sanal Makineler ve Container'lar
- Son Söz
Buraya kadar CPU’yu basit bir “talimat oku, yürüt, tekrar et” makinesi olarak anlattım. O resim yanlış değil, sadece eksik.
Sen bu cümleyi okurken önündeki işlemci muhtemelen yüzden fazla talimatı aynı anda havada tutuyor, bir sonraki if’in hangi tarafa sapacağını daha koşulu hesaplamadan tahmin ediyor ve o tahmine güvenip çoktan işe koyulmuş durumda. Bu bölümde ve sonrakinde o hilelerin her birini tek tek açacağız.
Bu bölümde işlemcinin “aynı anda daha fazla iş yapma” yollarını göreceğiz. Tahmin etmeye dayananları ise bir sonraki bölüme bırakıyorum, çünkü onların hikâyesi güvenlikle iç içe.
Bu bölümde neyi çözüyoruz?
- Tek bir çekirdeğin aynı çevrimde nasıl birden fazla talimat bitirdiğini göreceğiz.
- Pipeline’ın neden her zaman dolu akmadığını, hazardların nereden çıktığını çözeceğiz.
- Talimatların neden sırasız yürütülüp sıralı emekli edildiğini anlayacağız.
- SIMD’in tek talimatla çok veriye dokunmasını ve sınırının nereden geldiğini göstereceğiz.
Aynı Saatte Nasıl Daha Fazla İş Çıkar?
6. bölümde frekansın neden yirmi yıldır yerinde saydığını konuşmuştuk: Dennard ölçekleme çöktü ve saat hızını artırmanın bedeli doğrudan ısıya dönüştü. Sektörün buna iki ayrı cevap verdiğini de söylemiştim. Birincisi çekirdek çoğaltmaktı ve onu orada anlattım.
Bu bölüm ikinci cevabın hikâyesi: saat hızı artmıyorsa aynı saatte nasıl daha fazla iş yaparım? Hedef, o bölümde tanıştığın üç çarpandan ortadakini düşürmek — talimat başına harcanan çevrim sayısını. Buradaki hilelerin hepsi, tek bir çekirdeğin aynı vuruşta daha çok talimat bitirmesi üzerine kurulu.
Pipeline: Fabrika Bandı Gibi Çalışmak
İlk CPU’lar bir talimatı tamamen bitirmeden diğerine geçmezdi. Fetch, decode, execute, write-back adımları tek tek yapılırdı. Modern CPU’lar ise pipeline (boru hattı) kullanır. Fabrika bandı gibi, her aşamada farklı bir talimat bulunur.
| Aşama | Ne Yapar? |
|---|---|
| Fetch | Bellekten bir sonraki talimatı getir |
| Decode | Talimatı çözümle (ne yapacağını anla) |
| Execute | İşlemi gerçekleştir (toplama, çarpma vb.) |
| Memory | Gerekirse belleğe oku/yaz |
| Write-back | Sonucu register’a geri yaz |
Bunu bir tablo olarak değil, zaman içinde görmek çok daha ikna edici. Aşağıdaki şemayı adım adım ilerlet: her adım bir clock cycle, her satır bir talimat.
- 1. çevrim. Yalnızca ilk talimat işlenmeye başladı: bellekten getiriliyor (IF). Diğer dört aşama boş duruyor.
- 2. çevrim. Birinci talimat çözülürken (ID) ikinci talimat getiriliyor. Getirme birimi boş kalmadı — pipeline'ın bütün fikri bu.
- 3. çevrim. Üç aşama aynı anda çalışıyor. Hiçbir talimat daha bitmedi ama üçü birden yolda.
- 4. çevrim. Dört aşama dolu. Buraya kadar tek bir talimat bile tamamlanmadı; pipeline hâlâ doluyor.
- 5. çevrim: ilk sonuç. Birinci talimat WB aşamasında bitiyor ve beş aşama da dolu. Pipeline tam kapasiteye ulaştı.
- 6. çevrim: kararlı hâl. Artık her çevrimde bir talimat bitiyor. Tek bir talimat hâlâ beş çevrim sürüyor — değişen tek şey, aynı anda beş talimatın havada olması.
İlk dört çevrim boyunca hiçbir talimat bitmiyor; beşincide ilki biter ve o andan sonra her çevrimde bir tane bitmeye başlar. Pipeline’ın vaadi tam olarak bu: tek bir talimatı hızlandırmıyor, aynı anda kaç talimatın havada olduğunu artırıyor.
Aynı deseni daha uzun bir örnekte, dokuz talimat ve on dört çevrim üzerinde de görebilirsin:
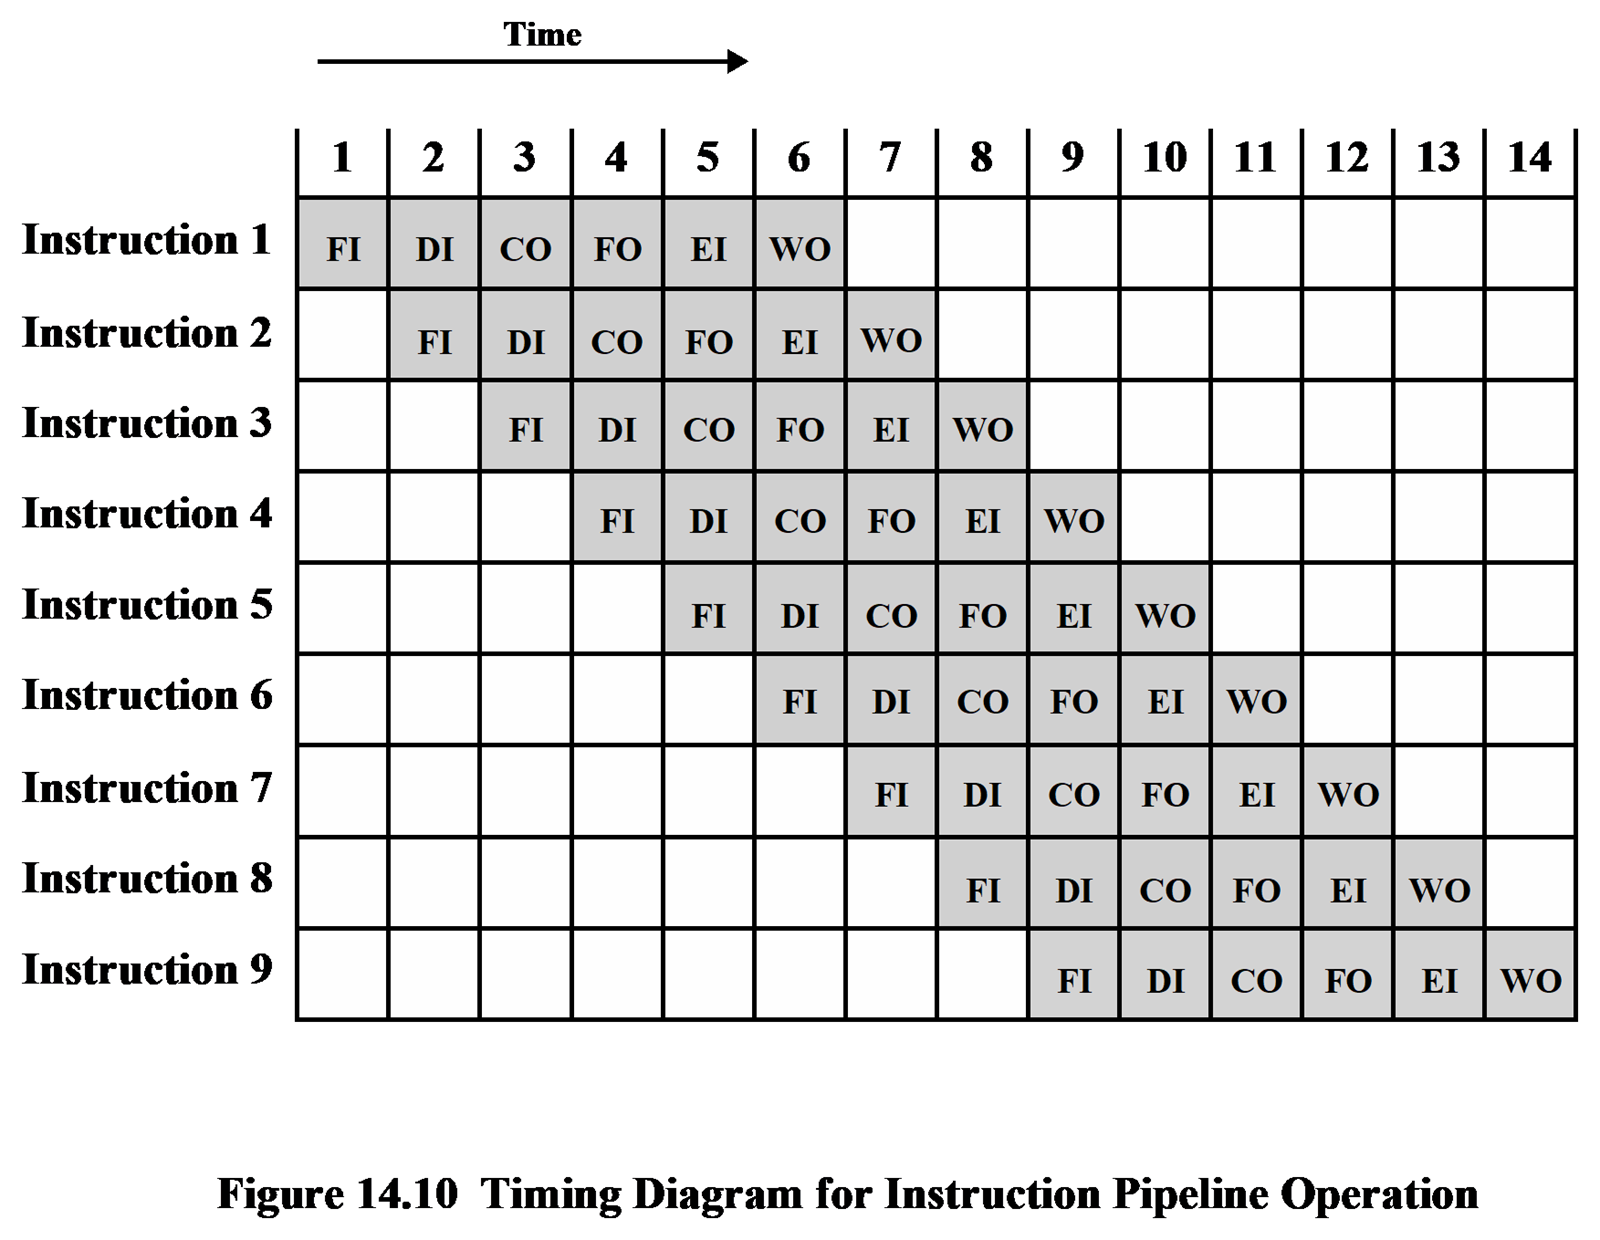
Kaynak: William Stallings, Computer Organization and Architecture, 10. baskı, Şekil 14.10.
Şemanın iki şeyi birden anlattığına dikkat et. Merdiven deseni pipeline’ın dolmasıdır: ilk talimat altı çevrim sürer, ama altıncı çevrimde artık altı talimat aynı anda ilerlemektedir. Bu noktadan sonra her çevrimde bir talimat tamamlanır — tek tek altı çevrim süren işler, ardışık geldiklerinde çevrim başına bire iner.
Bir de sol üstteki boşluğa bak: pipeline dolana kadar geçen o birkaç çevrim bedavaya gelmez. Kısa süren bir kod parçasında pipeline dolmadan iş biter ve vaat edilen hızlanma hiç gerçekleşmez.
Buradaki aşama isimleri (FI, DI, CO, FO, EI, WO) Stallings’in altı aşamalı modelinden geliyor ve yukarıdaki beş aşamalı tablodan biraz farklı bölünmüş. Aşama sayısı mimariye göre değişen bir tasarım tercihidir: klasik RISC beşte kalır, Pentium 4 yirmiyi aşmıştı. Derin pipeline saat hızını yükseltmeyi kolaylaştırır ama birazdan göreceğimiz yanlış tahmin cezasını da o oranda büyütür.
Pipeline Hazardları
Pipeline’ın verimli çalışması için talimatlar sürekli akmalıdır. Ama bant her zaman akmaz. Bazen bir talimat sırası geldiği hâlde kendi aşamasına giremez ve arkasındaki herkes onu bekler. Bu duruma hazard deniyor. Üç ayrı sebepten çıkar ve üçünü de tanıman gerekiyor, çünkü bu bölümün geri kalanındaki bütün hilelerin varlık sebebi bunlar.
- Structural hazard (yapısal): İki talimat aynı anda aynı donanım birimini kullanmaya çalışır. Örneğin tek bir bellek portu hem fetch hem memory aşamasında kullanılmak istenirse biri beklemek zorundadır.
- Data hazard (veri): Bir talimatın çalışması için önceki talimatın sonucuna ihtiyaç duyulur ama o sonuç henüz yazılmamıştır.
- Control hazard (kontrol): Koşullu dallanma (
if,jmp) sonrası hangi talimatın geleceği bilinmez; pipeline’ın doğru yoldan devam etmesi için beklenir veya tahmin edilir.
Veri hazardlarından en yaygın olanı Read-After-Write (RAW) bağımlılığıdır:
add eax, ebx
mov ecx, eax    ; önceki talimatın sonucunu bekliyor — stall'e sebep olur
mov ecx, eax talimatı eax’in güncellenmiş değerine ihtiyaç duyar. Eğer add talimatının write-back aşaması henüz tamamlanmadıysa, CPU bir veya daha fazla clock cycle stall (duraklama) ekler veya bypassing/forwarding ile sonucu doğrudan execute birimine yönlendirir.
Superscalar: Birden Fazla Fabrika Bandı
Pipeline tek bir fabrika bandıdır. Superscalar işlemciler ise aynı anda birden fazla talimatı farklı birimlerde yürütebilir. Örneğin bir toplama birimi ve bir çarpma birimi aynı anda çalışabilir.
- IPC: 6. bölümde tanıştığın çevrim başına talimat sayısı. Basit bir pipeline’da bu sayı en iyi ihtimalle 1’e yaklaşır; superscalar bir çekirdekte 1’in üstüne çıkabilir.
- Out-of-Order Execution: İşlemci, talimatların bağımsız olanlarını önce yürütüp bağımlı olanları bekletebilir. Bu, pipeline’ın boş kalmamasını sağlar.
Sıra Neden Bozulur?
Out-of-order execution modern işlemcinin en büyük hilesi ve — göreceğimiz gibi — Spectre’ın da altyapısı. O yüzden üç basamakta açalım.
Birinci basamak: beklemenin bulaşıcılığı. Bellekten veri bekleyen bir talimat düşün; cache miss olmuş, veri yüzlerce çevrim sonra gelecek. Sıralı bir işlemcide bu talimatın arkasındaki talimatlar da bekler. Oysa onların çoğunun bekleyen veriyle hiçbir alakası yoktur. Boş oturmalarının tek sebebi, kodda daha sonra yazılmış olmaları.
İkinci basamak: sahte bağımlılıklar. Sıra bozacaksan gerçek bağımlılıkları bilmen gerekir, ama register isimleri seni yanıltır:
mov eax, [mem1]   ; birinci iş
add eax, 5
mov eax, [mem2]   ; ikinci iş -- birinciyle hiçbir ilgisi yok
add eax, 9
Üçüncü satır ikinci satırı beklemek zorunda mı? Mantıken hayır; bunlar bambaşka iki hesap. Ama ikisi de eax adını kullanıyor. Bu bir veri bağımlılığı değil, isim bağımlılığıdır. Donanım bunu register renaming ile çözer: eax aslında bir isimdir ve çekirdeğin içinde onlarca fiziksel register vardır. İşlemci ikinci eax’e farklı bir fiziksel register verir, iki hesap birbirinden tamamen kopar ve aynı anda yürüyebilir.
Üçüncü basamak: sıra geri nasıl kuruluyor? Talimatlar sırasız yürütülür ama sıralı emekli edilir (retirement). Sonuçlar önce reorder buffer denen bir kuyrukta bekler; bir talimatın sonucu ancak kendinden önceki bütün talimatlar tamamlandığında dünyaya görünür olur. Programın kendi gördüğü sonuç bu yüzden her zaman sıralıdır.
O “kendi” kelimesinin altını çizerek geçtim, çünkü garanti tam olarak orada bitiyor. Sıralı emeklilik, aynı veriye bakan başka bir çekirdeğin de senin yazmalarını aynı sırayla göreceği anlamına gelmez — 10. bölümde konuştuğumuz store buffer bu iki dünyanın arasına giriyor. Tek thread için işlemci kusursuz bir yalan söyler; o yalan yalnızca dinleyici tek olduğu sürece tutar.
Bu üçüncü basamağı aklında tut: bir sonraki bölümde “mimari sonuçları geçici tutmak” dediğimde kastettiğim mekanizma tam olarak budur.
Paralelliğin Öteki İki Türü
Buraya kadar anlattığım her şey tek bir çekirdeğin içinde geçiyor. Pipeline, superscalar ve out-of-order yürütme, aynı çekirdeğin aynı çevrimde daha fazla talimat bitirmesini sağlar. Ama bu, paralelliğin üç türünden yalnızca biri ve diğer ikisini zaten tanıyorsun.
6. bölümde konuştuğumuz çok çekirdek, aynı çipin üzerine birbirinden bağımsız işlemciler koymaktır; her birinin kendi register seti ve kendi özel cache’i vardır. Aynı bölümdeki SMT ise tek bir çekirdeğin iki durum kopyası tutmasıdır — ikinci bir çekirdek değil, birincinin bekleme anları.
Üçüncü tür ise ne çekirdek sayısıyla ne de talimat sırasıyla ilgili. Tek bir talimatın kaç veri parçasına dokunduğuyla ilgili.
SIMD: Tek Talimat, Çok Veri
SIMD (Single Instruction, Multiple Data), tek bir talimatın aynı anda birden fazla veri parçası üzerinde çalışmasını sağlar. Örneğin iki dizinin karşılıklı elemanlarını dörder dörder tek talimatta toplarsın: a[0]+b[0], a[1]+b[1], a[2]+b[2], a[3]+b[3] — dört ayrı toplama değil, bir tane toplama talimatı.
Bunu mümkün kılan şey, normal register’lardan çok daha geniş özel register’lar. Genişliği anlamlı kılan da içine kaç sayı sığdığı:
| Kuşak | Register genişliği | 32-bit float | 64-bit double | 8-bit tam sayı |
|---|---|---|---|---|
| SSE | 128 bit | 4 | 2 | 16 |
| AVX / AVX2 | 256 bit | 8 | 4 | 32 |
| AVX-512 | 512 bit | 16 | 8 | 64 |
Register’ın bu dilimlerinin her birine lane (şerit) denir. Sekiz lane’li bir toplama talimatı, sekiz ayrı toplamanın işini tek çevrimde bitirir.
SIMD’in sınırını da hemen söyleyeyim, çünkü çoğu hayal kırıklığı buradan çıkar: bütün lane’ler aynı talimatı yürütmek zorundadır. Lane’ler arasında if yazamazsın. “Şu elemanlar için topla, şunlar için çıkar” demek istiyorsan, ikisini de hesaplayıp sonucu bir maske ile seçmen gerekir — yani işin bir kısmını baştan çöpe atarsın. Verinin düzenli olmadığı yerde SIMD’in kazancı hızla erir.
Video işleme, yapay zeka, bilimsel hesaplama gibi alanlarda SIMD kritik öneme sahiptir. Derleyiciler kodu kendiliğinden vektörize edebilir (auto-vectorization), ama işi sonuna kadar sıkmak istiyorsan intrinsic fonksiyonlarla vektör talimatlarını elle yazarsın.
DerinleşmeDaha geniş SIMD neden her zaman daha hızlı değil?
AVX-512 daha geniş register’lar ve daha fazla paralellik vaat eder, ama bu verimlilik bedelsiz değildir. 512-bit işlemler çekirdek içindeki vektör birimlerini çok daha yoğun kullanır ve bu doğrudan ısı artışına yol açar.
Bunun iki ayrı sonucu var. Birincisi klasik termal throttling: çip ısınır, saat hızı düşer. İkincisi daha sinsi — bazı Intel nesilleri AVX-512 talimatını görür görmez, daha ısınmamışken bile, o çekirdeği (bazen tüm çekirdekleri) önceden tanımlı daha düşük bir frekans kademesine indirir. Yani cezayı ısındığın için değil, ısınma ihtimalin olduğu için ödersin. Bu yüzden bulut tarafında AVX-512’nin varlığı instance tipine göre değişir; aynı sağlayıcının iki farklı nesil makinesinde aynı kod farklı hızlarda koşabilir. “Daha fazla SIMD” her zaman “daha hızlı” anlamına gelmez; iş yüküne, soğutmaya ve güç bütçesine bağlıdır.
Bu ceza Intel’de nesilden nesile küçüldü, AMD ise konuya başka bir yerden girdi: Zen 4, 512 bitlik talimatları iki ayrı 256 bitlik geçişle yürütür. Tepe hızın bir kısmından vazgeçer, karşılığında frekans cezası hiç ödemez. Aynı talimat, aynı sonuç, bambaşka bir iç düzen; 5. bölümdeki ISA ile mikro-mimari ayrımının bundan daha somut bir örneği zor bulunur.
Özet
Peki, ne öğrendik?
- Saat hızı tek başına artık artmıyor; kazanç aynı anda daha fazla iş yapmaktan geliyor.
- Pipeline, talimatları aşamalara böler ve her aşamada farklı bir talimat ilerletir.
- Superscalar yürütme aynı çevrimde birden fazla talimat başlatır; out-of-order yürütme ise bekleyen bir talimatın arkasındaki bağımsız işi öne alır.
- Talimatlar sırasız yürütülür ama sıralı emekli edilir. Programın gördüğü sonuç bu yüzden her zaman sıralıdır.
- SIMD, tek talimatla çok veriye dokunmaktır ve paralelliğin üçüncü türüdür; diğer ikisi, çok çekirdek ve SMT, 6. bölümün konusuydu.
Bu hilelerin hepsi sessiz bir varsayıma dayanıyor: CPU, sıradaki talimatın hangisi olduğunu biliyor. Peki kodda bir if varsa? Sıradaki bölümün konusu, işlemcinin bu soruya verdiği cevap — ve o cevabın onlarca yıl sonra açtığı devasa güvenlik deliği.